Senin pagi, agent diminta menambah satu endpoint. Hasilnya rapi. Selasa, agent diminta hal serupa, hasilnya beda: file ditaruh di folder lain, format error berbeda, dan tidak ada test. Rabu, agent diminta melanjutkan pekerjaan Senin, dan dia mengabaikan keputusan yang sudah diambil dua hari sebelumnya.
Tidak ada satu pun dari kejadian itu yang disebabkan model yang buruk. Semuanya disebabkan hal yang sama: aturan proyek hanya ditulis sebagai permintaan di sebuah file markdown, dan permintaan tidak bisa menegakkan apa pun.
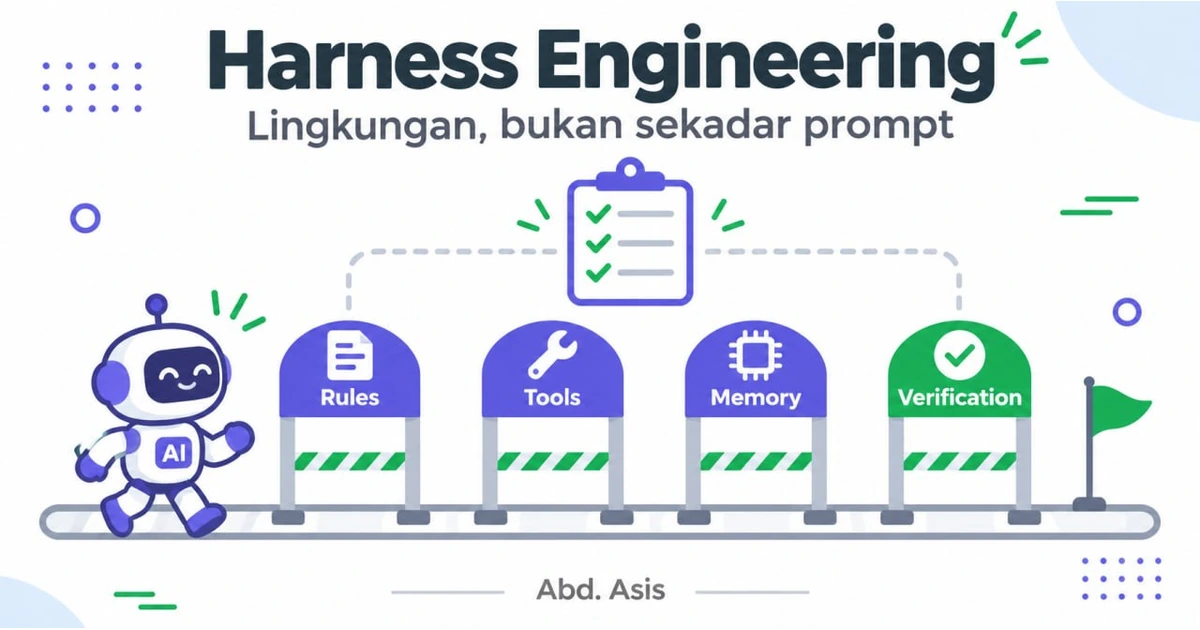
Di sinilah konsep harness masuk. Bukan cara menulis prompt yang lebih panjang, tapi cara membangun lingkungan tempat agent bekerja: batasan yang ditegakkan mesin, memori yang tidak hilang antar sesi, dan verifikasi yang tidak bisa dilewati.
Analogi yang menjelaskan namanya
Harness adalah perlengkapan yang dipasang pada kuda: pelana, kekang, dan tali kendali. Kuda punya tenaga jauh lebih besar dari penunggangnya, tapi tanpa perlengkapan itu tenaganya tidak terarah.
Agent AI mirip sekali. Kemampuannya besar, tapi dia tidak tahu ke mana harus pergi tanpa struktur yang mengarahkan. Markdown berisi aturan hanya memberitahu arah. Harness memberi arah itu bentuk: pagar yang tidak bisa dilewati, jejak yang bisa dibaca ulang, dan pemeriksaan yang menolak hasil kerja yang belum memenuhi syarat.
Satu definisi kerja yang saya pakai: setiap kali agent melakukan kesalahan, jangan hanya memperbaiki hasilnya. Ubah lingkungan supaya kesalahan yang sama tidak bisa terulang.
Tiga tahap yang hampir semua tim lewati
Perkembangan ini terjadi cukup cepat, dan sebagian besar tim melewati tahapannya berurutan tanpa menyadarinya.
| Tahap | Isi | Yang masih kurang |
|---|---|---|
| Aturan satu file | satu CLAUDE.md atau AGENTS.md berisi stack dan konvensi | aturan hanya permintaan, konteks hilang antar sesi |
| Aturan dipecah | folder rules/ per topik, standar lintas tool | tidak ada penegakan, urutan kerja masih improvisasi |
| Harness | aturan plus skill, hook, memori, loop verifikasi | butuh disiplin merawat |
Tahap pertama terasa seperti lompatan besar karena hasil pertama biasanya bagus. Masalahnya muncul saat proyek membesar: kualitas jadi bervariasi, sesi terputus, dan daftar skill menumpuk sampai tidak ada yang tahu urutan menjalankannya.
Tahap kedua memperbaiki kerapian, tapi menambah satu ilusi: karena aturannya sudah ditulis dengan rapi, kita merasa aturan itu berlaku. Padahal tidak ada yang memeriksa.
Empat bagian harness
Harness bukan satu alat. Dia tersusun dari empat bagian yang saling menutup.
1. Skill: prosedur, bukan pengetahuan
Pengetahuan menjawab "apa". Skill menjawab "bagaimana, dalam urutan apa, dan bagaimana tahu sudah selesai".
Skill yang berguna punya bentuk yang khas: kapan dipakai, langkah bernomor dengan perintah persis, jebakan yang sudah diketahui, dan cara memverifikasi hasilnya.
---
name: tambah-endpoint
description: Pakai ketika menambah endpoint API baru di proyek ini.
---

# Menambah endpoint API

## Kapan dipakai
Permintaan berisi "tambah endpoint", "buat API", atau "buat route baru".

## Langkah
1. Tulis test permintaan lebih dulu di `tests/Feature/`.
2. Buat FormRequest dengan aturan validasi.
3. Buat controller yang hanya memanggil service.
4. Daftarkan route di `routes/api.php`, kelompokkan sesuai modul.
5. Jalankan `php artisan test --filter=NamaTest`.

## Jebakan
- Jangan menyimpan logika di controller; service sudah ada untuk itu.
- Format error mengikuti `App\Support\ApiResponse`, jangan bikin format baru.

## Verifikasi
- Test lulus.
- `composer types:check` bersih.
Perhatikan bagian verifikasi. Skill tanpa kriteria selesai akan dianggap selesai saat agent merasa sudah, bukan saat buktinya ada.
Kesalahan umum: menulis dua puluh skill sekaligus. Mulai dari dua yang paling sering dipakai, lalu tambah satu setiap kali ada kesalahan yang berulang.
2. Hook: aturan yang ditegakkan mesin
Hook adalah titik di mana lingkungan menolak, bukan mengingatkan. Dia berjalan otomatis pada kejadian tertentu: setelah file disimpan, sebelum perintah shell dijalankan, sebelum commit.
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Write|Edit",
        "hooks": [
          { "type": "command", "command": "python3 .harness/format_and_lint.py" }
        ]
      }
    ],
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": "python3 .harness/guard_danger.py" }
        ]
      }
    ]
  }
}
Isi skripnya bisa sesederhana ini:
 PYTHON
"""Tolak perintah yang menyentuh database produksi tanpa izin eksplisit."""
import json, sys

perintah = json.load(sys.stdin).get("tool_input", {}).get("command", "")
terlarang = ("migrate:fresh", "db:wipe", "DROP DATABASE", "TRUNCATE")

if any(kata in perintah for kata in terlarang):
    print("Ditolak: perintah destruktif butuh persetujuan manusia.", file=sys.stderr)
    sys.exit(2)  # exit 2 = blokir, bukan cuma peringatan
Tiga hook yang paling cepat memberi hasil:
- format dan lint setelah file ditulis, supaya tidak ada lagi commit yang isinya cuma memperbaiki spasi
- pola berbahaya sebelum perintah dijalankan:
console.log, kredensial hardcoded, perintah destruktif - cek tipe atau build sebelum tugas dinyatakan selesai
Batasannya jelas: hook yang terlalu banyak akan melambatkan setiap langkah, dan hook yang salah akan memblokir pekerjaan yang sah. Mulai dari tiga, bukan tiga puluh.
3. Memori: ditulis di luar, bukan diandalkan di dalam
Konteks model hilang antar sesi. Itu bukan bug yang akan diperbaiki, itu sifat alatnya. Jadi keputusan penting harus ditulis ke berkas yang bisa dibaca ulang.
Yang layak ditulis:
- keputusan arsitektur beserta alasannya, misalnya "autentikasi memakai NextAuth karena sesi sudah ada di reverse proxy"
- konvensi yang tidak terlihat dari kode, misalnya "semua nominal disimpan dalam integer rupiah"
- hal yang sudah dicoba dan gagal, supaya tidak diulang
Yang tidak layak ditulis: daftar aktivitas harian, isi commit, dan progres yang bisa dibaca dari git log.
# progress.md

## Keputusan
- 2026-11-04: autentikasi memakai NextAuth, bukan JWT buatan sendiri.
  Alasan: sesi sudah dikelola reverse proxy, dan refresh token sudah ada.
- 2026-11-06: nominal disimpan sebagai integer rupiah, tanpa desimal.

## Gagal dicoba
- 2026-11-07: migrasi kolom uang ke `numeric(12,2)` membuat laporan lama melambat 3x.

## Berikutnya
- Endpoint refund belum punya test idempotensi.
Struktur seperti ini membuat agent di sesi baru bisa mulai dari keputusan, bukan dari nol.
4. Loop verifikasi: definisi selesai yang tidak bisa ditawar
Bagian ini yang paling sering dilewati karena terasa lambat. Padahal tanpa ini, harness hanya menambah dokumentasi.
Tugas dianggap selesai hanya kalau semuanya benar:
 BASH
php artisan test
composer types:check
npm run build
Kalau salah satu gagal, tugas belum selesai. Titik. Tidak ada negosiasi "nanti saya perbaiki di commit berikutnya", karena commit berikutnya biasanya tidak datang.
Kiat praktis: buat satu skrip tunggal yang menjalankan ketiganya, lalu minta agent selalu memanggil skrip itu. Satu perintah lebih mudah diingat daripada tiga, dan lebih mudah dipasang di hook.
Bedanya saat mengerjakan satu tugas nyata
Saya pakai satu tugas yang sama, "tambahkan API autentikasi", untuk melihat bedanya.
| Aspek | Hanya aturan markdown | Dengan harness |
|---|---|---|
| Keputusan lama | diabaikan, agent memilih pola sendiri | dibaca dari catatan keputusan, dipatuhi |
| Urutan kerja | bervariasi antar sesi | mengikuti skill, jenis lalu logika lalu endpoint lalu test |
| Kebocoran rahasia | ketahuan saat review manusia | ditolak hook sebelum file tersimpan |
| Format error | berbeda dari endpoint lain | dipaksa memakai helper yang sudah ada |
| Test | tidak ada | wajib, karena gate verifikasi |
| Kondisi akhir | "kelihatannya jalan" | terbukti lulus test, tipe, dan build |
Perbedaan paling penting bukan pada satu baris hasil, tapi pada siapa yang menemukan masalah. Tanpa harness, manusia yang menemukan. Dengan harness, mesin yang menemukan lebih dulu, saat biaya perbaikannya masih rendah.
Membangun harness dalam satu hari
Kalau kamu ingin mulai besok, urutan ini cukup:
- Tulis satu berkas keputusan. Isi lima keputusan arsitektur terakhir beserta alasannya. Ini yang paling cepat memberi dampak.
- Pasang tiga hook. Format dan lint setelah menulis file, penolakan perintah destruktif, dan cek tipe sebelum selesai.
- Tulis dua skill. Pilih dua tugas yang paling sering kamu minta ke agent, lalu catat langkahnya persis seperti kamu mengerjakannya sendiri.
- Buat satu skrip verifikasi. Satu perintah yang menjalankan test, tipe, dan build.
- Kerjakan satu tugas nyata dari awal sampai selesai dengan harness itu. Catat di mana agent tersandung.
- Tambahkan satu guardrail untuk setiap kesalahan. Aturan baru hanya lahir dari kesalahan yang benar-benar terjadi, bukan dari daftar keinginan.
Langkah keenam yang membuat harness tumbuh. Harness yang baik tidak dirancang sekali jadi, dia menumpuk dari pengalaman.
Kesalahan yang membuat harness gagal
Hook terlalu banyak. Setiap hook menambah waktu dan titik gagal. Kalau agent butuh sepuluh menit hanya untuk memulai, orang akan mematikan hook-nya.
Skill terlalu panjang. Skill setebal dokumen tidak akan dibaca sampai selesai. Kalau perlu lebih dari satu halaman, pecah jadi dua skill.
Memori berubah jadi buku harian. Kalau catatan berisi semua yang terjadi, tidak ada yang bisa menemukan keputusan penting di dalamnya.
Verifikasi yang bisa dilewati. Begitu ada satu tugas yang lolos tanpa test, standarnya sudah turun untuk semua tugas berikutnya.
Aturan yang saling bertentangan. Dua aturan yang bertabrakan membuat agent memilih salah satunya secara acak, dan hasilnya jadi tidak bisa diprediksi.
Harness tidak menggantikan penilaian manusia. Dia memindahkan pekerjaan manusia dari memeriksa hal yang bisa diperiksa mesin, ke memeriksa hal yang butuh pertimbangan: apakah masalahnya benar, apakah desainnya masuk akal, apakah biayanya sepadan.
Cara mengukur apakah harness-mu bekerja
Jangan menilai harness dari seberapa rapi berkasnya. Nilai dari empat angka:
| Metrik | Target sehat |
|---|---|
| Kesalahan yang sama terulang | nol setelah guardrail dipasang |
| Waktu dari tugas mulai sampai semua gate hijau | menurun tiap bulan |
| Waktu review manusia per pull request | menurun |
| Jumlah commit perbaikan setelah review | menurun |
Kalau keempatnya tidak bergerak setelah sebulan, harness-mu kemungkinan hanya dokumentasi yang rapi. Itu bukan kegagalan fatal, tapi tanda bahwa bagian penegakan dan verifikasi belum benar-benar berjalan.
Penutup
Di dunia agent AI, yang membedakan tim bukan panjang prompt atau model terbaru. Yang membedakan adalah apakah lingkungannya dirancang untuk menolak hasil yang buruk, atau hanya berharap hasilnya baik.
Tiga prinsip yang bisa kamu bawa pulang:
- aturan ditegakkan mesin, bukan diminta lewat tulisan
- memori ditulis di luar agent, bukan diandalkan di dalam konteks
- rancang dengan asumsi kegagalan akan terjadi, dan pastikan pemulihannya murah
Mulailah dari satu berkas keputusan dan tiga hook. Dalam beberapa hari, kamu akan melihat sendiri bedanya: agent berhenti mengulang kesalahan yang sama, dan waktumu pindah dari memperbaiki hasil menjadi memutuskan hal yang lebih penting.