Dashboard laporan bulanan di salah satu proyek saya butuh empat belas detik untuk terbuka. Tidak ada yang crash, tidak ada error, dan tidak ada satu pun halaman yang terlihat salah. Yang ada hanya spinner yang berputar terlalu lama, di halaman yang dibuka setiap pagi oleh tim finance.
Setelah dibedah, masalahnya bukan di server yang kurang RAM dan bukan di framework. Penyebabnya enam query yang masing-masing memakan 40 sampai 300 milidetik, ditambah satu loop yang menjalankan query serupa enam puluh kali. Setelah diperbaiki, halaman yang sama terbuka dalam 700 milidetik.
Sebagian besar perbaikan itu datang dari trik SQL yang sebenarnya sudah dikenal banyak orang. Yang membedakan bukan pengetahuan, tapi kebiasaan memeriksa query sebelum menyalahkan lapisan lain.
Ringkasan sepuluh trik
| Trik | Masalah yang diselesaikan | Dampak tipikal |
|---|---|---|
Pilih kolom, bukan * | data yang dibaca dan dikirim terlalu banyak | sedang sampai besar |
| Pahami index, termasuk yang tidak terpakai | full table scan tanpa disadari | besar |
EXISTS daripada COUNT | menghitung semua baris hanya untuk tahu ada atau tidak | sedang |
| Window function | self join berlapis untuk ranking dan running total | besar |
| CTE untuk keterbacaan | query 200 baris yang tidak bisa direview | kecil untuk performa, besar untuk perawatan |
| Hindari N+1 | 1 query berubah jadi 101 query | sangat besar |
| Baca execution plan | optimasi berdasarkan tebakan | besar |
UPSERT | cek-lalu-tulis yang rawan race condition | sedang |
| Keyset pagination | OFFSET besar yang makin lambat | besar |
| Kerjakan agregasi di database | jutaan baris dipindah ke aplikasi | sangat besar |
Urutannya bukan urutan prioritas. Yang paling sering memberi hasil paling cepat di aplikasi nyata adalah N+1 dan keyset pagination.
1. Berhenti memakai SELECT *
Ini nasihat tertua di dunia SQL dan masih dilanggar setiap hari.
-- jangan
select * from users where id = 123;

-- pakai
select name, email from users where id = 123;
Alasannya bukan gaya penulisan. Ada tiga biaya yang ikut hilang:
- basis data membaca lebih sedikit halaman dari disk, terutama kalau tabelnya punya kolom JSON besar atau kolom teks panjang
- jaringan mengirim lebih sedikit byte
- aplikasi menghabiskan lebih sedikit waktu mengubah hasil menjadi objek
Pada tabel dengan empat puluh kolom dan kolom settings bertipe jsonb, perbedaan select * dan dua kolom bisa mencapai puluhan kali lipat untuk satu baris. Kalikan dengan seratus ribu baris yang diproses laporan.
Ada satu pengecualian yang sah: query eksplorasi di psql, waktu kamu memang belum tahu kolom apa yang ada.
2. Index bukan sulap, dan sering tidak terpakai
Index mempercepat pembacaan dengan mengorbankan penulisan. Setiap INSERT, UPDATE, dan DELETE harus memperbarui index juga. Jadi pertanyaan yang benar bukan "kenapa tidak pakai index", tapi "kenapa index-nya tidak dipakai".
create index idx_orders_customer on orders(customer_id);
Index di atas akan dipakai untuk pencarian yang sederhana:
select id, total from orders where customer_id = 42;
Tapi jadi tidak berguna begitu kolomnya dibungkus fungsi:
-- index pada kolom email tidak dipakai
select id from users where lower(email) = '[email protected]';
Solusinya dua, dan keduanya lebih baik daripada mengubah query menjadi LIKE:
-- expression index
create index idx_users_email_lower on users (lower(email));

-- atau kolom turunan yang disimpan
alter table users add column email_normalized text
  generated always as (lower(email)) stored;
create index idx_users_email_normalized on users (email_normalized);
Pola serupa berlaku untuk perbandingan antar tipe yang berbeda, misalnya kolom varchar dibandingkan dengan angka, dan untuk LIKE '%kata%' yang memang tidak bisa memakai index B-tree biasa. Untuk pencarian teks, yang kamu butuhkan index trigram atau full text, bukan B-tree.
| Penyebab index tidak dipakai | Perbaikan |
|---|---|
| Kolom dibungkus fungsi | expression index atau generated column |
| Tipe data berbeda saat dibandingkan | samakan tipe, atau buat index dengan cast |
LIKE '%…%' di depan | index trigram (pg_trgm) atau full text |
| Statistik tabel basi | ANALYZE pada tabel itu |
Kondisi OR lintas kolom | pecah jadi UNION, atau index komposit yang sesuai |
| Fungsi mengembalikan sebagian besar baris | memang wajar, sequential scan lebih murah |
3. EXISTS kalau yang kamu butuh hanya "ada atau tidak"
Pola yang sangat umum: menjalankan COUNT hanya untuk memeriksa apakah sebuah email sudah terdaftar.
-- membebani database tanpa alasan
select count(*) from users where email = '[email protected]';
-- lalu di aplikasi: count > 0
COUNT harus menghitung semua baris yang cocok. EXISTS boleh berhenti di baris pertama.
select exists (
    select 1 from users where email = '[email protected]'
);
Untuk tabel dengan jutaan baris dan kolom yang tidak unik, selisihnya bisa terasa. Bonusnya, EXISTS mengembalikan boolean, jadi logika di aplikasi jadi lebih jelas.
4. Window function: agregasi tanpa kehilangan baris
Window function adalah fitur yang paling sering diabaikan, padahal dia menghapus banyak self join yang menyakitkan.
Ranking:
select
    name,
    salary,
    rank() over (order by salary desc) as peringkat
from employees;
Running total:
select
    order_date,
    amount,
    sum(amount) over (order by order_date) as total_berjalan
from orders;
Yang paling sering saya pakai di laporan: mengambil satu baris terbaru per grup, tanpa subquery berlapis.
select *
from (
    select
        *,
        row_number() over (
            partition by customer_id
            order by created_at desc
        ) as urutan
    from orders
) t
where urutan = 1;
Pola row_number() ini menggantikan distinct on yang khas PostgreSQL dan group by dengan join balik ke tabel yang sama. Hasilnya lebih mudah dibaca dan biasanya lebih cepat karena hanya satu kali pemindaian.
5. CTE untuk keterbacaan
Query yang join enam tabel dan punya tiga subquery bersarang bukan tanda keahlian. Itu tanda tidak ada yang bisa mereview perubahan berikutnya.
with pengguna_aktif as (
    select id, name from users where status = 'ACTIVE'
),
pesanan_30_hari as (
    select user_id, sum(total) as nilai
    from orders
    where created_at > current_date - interval '30 days'
    group by user_id
)
select p.name, coalesce(o.nilai, 0) as nilai
from pengguna_aktif p
left join pesanan_30_hari o on o.user_id = p.id
order by nilai desc;
Catatan teknis yang jarang diketahui: di PostgreSQL 12 ke atas, CTE yang tidak dipakai berulang akan di-inline oleh planner, jadi kekhawatiran lama "CTE selalu jadi optimization fence" sudah tidak berlaku. Kalau kamu ingin memaksa materialisasi, tulis with x as materialized (...).
6. N+1: satu query jadi seratus satu
Ini penyebab nomor satu dashboard lambat yang saya temui, dan biasanya bukan salah basis data.
 PHP
// 1 query untuk daftar pesanan
$orders = Order::limit(100)->get();

// lalu 100 query tambahan, satu per pesanan
foreach ($orders as $order) {
    echo $order->customer->name;
}
Totalnya 101 query. Solusinya satu baris di sisi ORM:
PHP$orders = Order::with('customer')->limit(100)->get();
Atau satu join kalau memang hanya butuh beberapa kolom:
select o.id, o.total, c.name as customer
from orders o
join customers c on c.id = o.customer_id
order by o.id desc
limit 100;
Cara mendeteksinya jangan mengandalkan feeling. Nyalakan query log di lingkungan lokal, jalankan satu halaman, lalu hitung. Kalau jumlah query tumbuh mengikuti jumlah baris di layar, itu N+1.
7. Execution plan bukan dokumen rahasia
EXPLAIN menunjukkan rencana, EXPLAIN ANALYZE menjalankan query dan menunjukkan waktu nyata per node.
explain (analyze, buffers)
select id, total from orders where customer_id = 42;
Yang perlu dibaca, berurutan:
- Jenis scan.
Seq Scanpada tabel besar dengan filter selektif berarti index tidak dipakai. - Estimasi vs realita. Kolom
rowsperkiraan planner,actual rowskenyataan. Selisih jauh (misalnya estimasi 10, aktual 90.000) berarti statistik tidak akurat atau korelasinya tidak diketahui planner. - Nested Loop yang besar. Nested loop wajar untuk puluhan baris, bukan untuk ratusan ribu.
Buffers. Angkashared readyang besar berarti data diambil dari disk, bukan cache.
EXPLAIN ANALYZE benar-benar menjalankan query. Untuk UPDATE atau DELETE yang berbahaya, bungkus dengan transaksi lalu ROLLBACK, atau pakai EXPLAIN tanpa ANALYZE dulu untuk melihat rencananya saja.
8. UPSERT menggantikan cek-lalu-tulis
Pola lama: cek apakah baris ada, kalau tidak ada insert, kalau ada update. Selain dua round trip, pola ini punya lubang: di antara cek dan tulis, proses lain bisa menyisipkan baris yang sama.
insert into users (id, email, updated_at)
values (1, '[email protected]', now())
on conflict (id) do update
set email = excluded.email,
    updated_at = excluded.updated_at;
Operasinya atomik, satu round trip, dan tidak ada jendela race condition. Di MySQL padanannya INSERT ... ON DUPLICATE KEY UPDATE, di SQL Server MERGE.
Yang perlu diperhatikan: ON CONFLICT hanya bekerja kalau ada unique constraint atau unique index pada kolom yang disebut. Tanpa itu, konfliknya tidak terdeteksi, dan kamu hanya menambah baris duplikat.
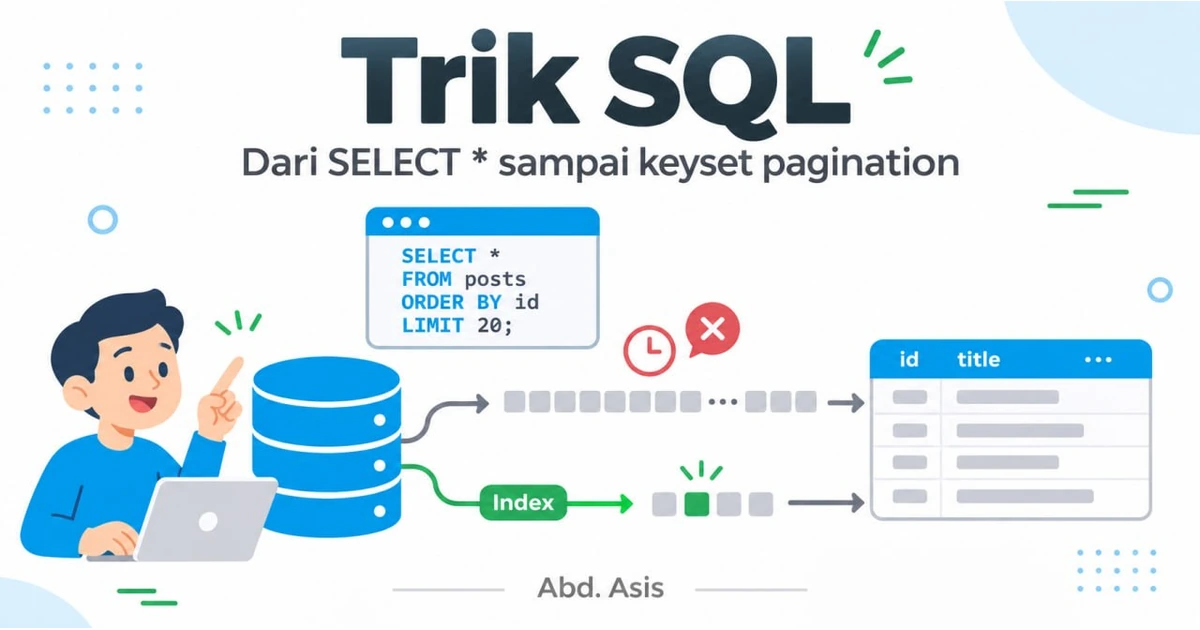
9. Pagination yang tidak melambat seiring waktu
Halaman pertama selalu cepat. Halaman seribu yang bermasalah.
-- makin besar offset, makin lambat
select id, total from orders order by id limit 50 offset 100000;
OFFSET memaksa basis data melewati seratus ribu baris sebelum mengambil lima puluh. Biayanya tumbuh linear terhadap offset.
Keyset pagination memakai nilai terakhir sebagai penanda:
select id, total
from orders
where id > 100000
order by id
limit 50;
Query ini memakai index pada id dan langsung melompat ke posisi yang diminta, berapa pun halaman yang sudah dilewati.
Harganya: kamu tidak bisa melompat ke halaman tujuh langsung, dan penandanya harus unik serta terurut. Untuk feed, daftar transaksi, dan log, itu batasan yang bisa diterima. Untuk tabel admin yang butuh nomor halaman, OFFSET masih wajar selama datanya tidak raksasa.
10. Kerjakan di database, bukan di aplikasi
Kesalahan yang mahal: mengambil seluruh tabel ke memori, lalu menyaring dan menjumlahkan di kode.
PHP// jangan
$total = Transaction::all()->groupBy('account_id')->map->sum('amount');
Basis data dirancang untuk menyaring, mengelompokkan, dan menjumlahkan, dengan index dan cache halaman yang sudah dioptimalkan bertahun-tahun.
select account_id, sum(amount) as total
from transactions
where created_at >= date_trunc('month', current_date)
group by account_id;
Aturan praktisnya: pindahkan data ke aplikasi hanya kalau kamu memang butuh setiap barisnya untuk sesuatu yang tidak bisa dikerjakan SQL. Kalau hanya butuh angka akhir, biarkan database yang menghitung.
Untuk pemindahan data dalam jumlah besar ke arah sebaliknya, jangan lakukan INSERT satu per satu. Di PostgreSQL ada COPY, di MySQL ada LOAD DATA, dan Laravel punya insert() batch. Perbedaan waktunya bukan sepuluh persen, tapi sering kali sepuluh kali.
Urutan memeriksa saat query lambat
Kalau kamu mendapat laporan "halaman ini lambat", urutan ini menghemat banyak waktu:
- Ukur dulu, jangan menebak. Catat waktu respons sebelum perubahan apa pun.
- Hitung jumlah query per request. Kalau tumbuh mengikuti jumlah baris, itu N+1.
- Ambil query paling lambat, jalankan
EXPLAIN (ANALYZE, BUFFERS). - Cek jenis scan dan selisih estimasi dengan aktual.
- Baru pertimbangkan index baru. Ingat biaya tulisnya.
- Kalau masalahnya jumlah data yang dipindah, pindahkan agregasi ke SQL.
- Kalau masalahnya halaman jauh, ganti
OFFSETdengan keyset.
Urutan ini penting karena langkah 5 paling sering dikerjakan lebih dulu. Menambah index tanpa membaca plan seperti menambah obat tanpa diagnosis: kadang sembuh, sering hanya menambah biaya.
Yang sering dilupakan
Tiga hal kecil yang pengaruhnya besar dan jarang masuk daftar trik:
Transaksi membuat query terlihat lambat padahal bukan. Query 5 milidetik yang menunggu lock selama 2 detik akan tampil sebagai query lambat di log aplikasi. Periksa pg_stat_activity atau SHOW PROCESSLIST sebelum menyalahkan query.
Koneksi database punya batas. Aplikasi dengan 200 worker dan 20 koneksi akan menghabiskan waktu menunggu koneksi, bukan menunggu query. Connection pooler seperti PgBouncer menyelesaikan ini tanpa mengubah satu baris SQL.
Denormalisasi adalah keputusan, bukan kemalangan. Kalau kamu sengaja menyimpan kolom agregat untuk menghindari join berat, tulis alasannya di migrasi. Saya pernah membahas kapan normalisasi berhenti membantu di artikel skema database.
Penutup
Tidak ada satu pun trik di atas yang baru. Semuanya ada di dokumentasi resmi masing-masing basis data, dan sebagian besar sudah dikenal sejak bertahun-tahun lalu.
Yang membedakan engineer yang query-nya jalan dan yang query-nya jalan dengan baik bukan hafalan fitur. Bedanya ada di kebiasaan: membaca rencana eksekusi sebelum menambah index, menghitung jumlah query sebelum menambah server, dan memilih keyset pagination sebelum tabelnya menjadi masalah.
Mulailah dari satu halaman yang paling lambat di aplikasimu hari ini. Ukur, baca plan-nya, lalu perbaiki satu hal. Satu perbaikan yang terukur lebih berguna daripada sepuluh trik yang tidak pernah dipasang.